Ein Kunde hat mir letzte Woche einen Screenshot einer App geschickt, die er in Kürze launcht. Es ist ein SaaS-Produkt speziell für Dentallabore: Auftragsannahme, Fallverfolgung und der Papierkram, den ein Labor sonst in einem Ordner und einem WhatsApp-Verlauf aufbewahrt. Er ist gerade in der letzten Testrunde. Die Oberfläche ist sauber, die Abläufe sind fertig, und das Produkt ist fast bereit für Kunden.
Gebaut hat er es mit einem Hermes-Agenten auf einem isolierten VPS, mit DeepSeek als LLM-Provider. Nicht "mit KI-Unterstützung" in der üblichen Bedeutung, bei der ein Modell eine Funktion vorschlägt und ein Mensch sie einfügt. Der Agent arbeitete direkt auf dem eigenen Server. Mit eigenem GIT-Repository, Shell, und einem Deployment-Ziel. Jede Änderung wurde versioniert und dokumentiert. Als die Anwendung fertig war, hat der Agent die App sogar selbst auf den Produktionsserver gestellt.
Dann tat der Kunde etwas, das ich interessanter fand als den Launch.
Die zweite Meinung
Der Kunde hatte ChatGPT Pro genutzt, bevor er zu einem unserer Agenten gewechselt ist. Seit einem Monat läuft das isolierte Hermes-Setup, und er sagt, er ist beeindruckt. Aber er wollte eine "Kontrolle", also gab er die fertige Anwendung zu ChatGPT für ein Review. Praktisch wie ein zweites Paar Augen, vom bekanntesten Modell am Markt.
Das Review kam mit einer Liste von dramatisch klingenden Problemen zurück. Fehlende Teile, kaputte Pfade, Dinge, die nicht funktionieren würden. Es las sich wie ein ernsthaftes Audit.
Keiner der Punkte hielt jedoch stand.
Er bat den Hermes-Agenten, die Liste gegen den tatsächlichen Code zu prüfen. Der Agent öffnete die Dateien, las die Funktionen, prüfte das Schema, sah sich das Deployment an und ging die Behauptungen einzeln durch. Jedes gemeldete Problem war entweder nicht vorhanden, bereits gelöst oder eine Fehllesung einer Datei, die ChatGPT nie gesehen hatte. Der Agent hat nicht diskutiert. Er hat die Belege gezeigt: diese Datei, diese Zeile, dieser Commit, dieser Endpoint, der auf dem Server antwortet.
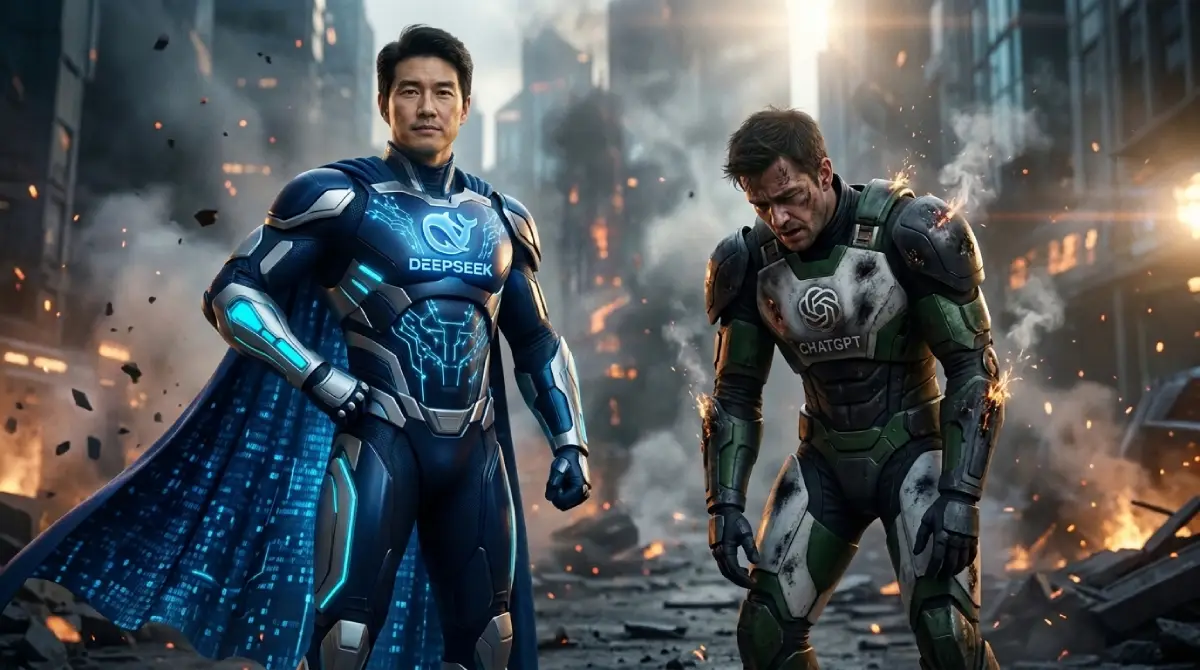
Das weniger teure Modell auf einem sauber gebauten Setup hat das berühmte in Minuten widerlegt. Das ist der Teil, der es wert ist, aufgeschrieben zu werden.
Aber die Schlussfolgerung, zu der die meisten vermutlich jetzt springen, ist die falsche. Es war kein Wettstreit zwischen zwei Sprachmodellen. Die beiden Prüfer waren nie im selben Rennen.
Deshalb ist dieses Review kein fairer Vergleich
ChatGPT bekam einen Code als Text in einem Chatfenster. Es hatte kein echtes Dateisystem. Es konnte keine Datei öffnen, die ihm nicht gegeben wurde, keinen Test ausführen, keine Git-Historie lesen, keine Datenbank abfragen und nicht sehen, was der Server tatsächlich auslieferte. Alles, was es über die Anwendung sagte, musste aus einer Beschreibung der Anwendung abgeleitet werden.
Also tat es, was ein LLM tut, wenn es nicht prüfen kann. Es lieferte die plausibelste Antwort. Und eine plausible Antwort über Software klingt genau wie eine echte. "Hier fehlt Fehlerbehandlung" stimmt für fast jede junge Codebasis und ist hier falsch. "Das wird beim Deployment scheitern" ist eine vernünftige Vermutung bei jeder Anwendung. Eine Vermutung ist kein Befund.
Der Hermes-Agent hatte die umgekehrte Situation: Er konnte prüfen, also musste er es tun. Nichts in seiner Antwort musste abgeleitet werden, weil der Beleg einen Befehl entfernt war.
Das ist der eigentliche Unterschied, und er hat fast nichts mit der LLM-Qualität zu tun.
Ein LLM ohne Zugriff auf das Dateisystem ist ein sehr belesener Mensch am Telefon. Es kann über Ihren Code sprechen. Es kann ihn aber nicht ansehen.
Was Infrastruktur tatsächlich bedeutet
Wenn ich sage, die Infrastruktur ist wichtiger als das Modell, meine ich keinen größeren Server. Ich meine die Umgebung, in der das Modell arbeitet.
Eine dedizierte Maschine mit Shell, damit der Agent auch ausführen kann, was er schreibt. Ein echtes Repository, damit jede Änderung sichtbar, umkehrbar und zuordenbar ist. Zugriff auf das Deployment-Ziel, damit "läuft auf meinem VPS" nicht das Ende des Gesprächs ist. Logs und Monitoring, damit eine Aussage über Produktion gegen Produktion geprüft werden kann. Guardrails, Backups und ein Rollback-Pfad, damit ein Fehler Minuten kostet und keinen Kunden. Und ein menschlicher Prozess um alles herum, denn ein Agent mit Root-Zugriff und ohne Aufsicht ist keine Strategie.
Ein Agent mit dieser Umgebung kann Arbeit abschließen. Ein Agent ohne sie kann nur Vorschläge zur Arbeit machen. Diese Lücke ist der Unterschied zwischen einem echten Kollegen und einem Chatfenster.
Das Modell zählt weiter, nur weniger als Sie denken
Ich werde nicht behaupten, die richtige Wahl des LLM's wäre irrelevant. Es ist nicht irrelevant. Ein schwaches LLM in einer perfekten Umgebung schreibt weiterhin schwachen Code, und die Differenz zahlen Sie am Ende wieder in Review-Zeit.
Aber die Mindestleistung, die die meisten annehmen, liegt viel tiefer als sie tatsächlich ist, und der Boden ist viel höher als erwartet. Ein kompetentes LLM mit der richtigen Umgebung schlägt ein exzellentes Modell mit Chatfenster und Vermutung, konsistent, bei jeder Aufgabe. Deshalb empfehlen wir nicht das teuerste Modell am Markt. Wir verkaufen das Setup: den Server, das Deployment, die Versionskontrolle, die Leitplanken und das Urteilsvermögen von Leuten, die Produktionssysteme lange betrieben haben.
Was wir tatsächlich verkaufen
Unsere Agenten sind von Senior-Webentwicklern vorab trainiert. Dieser Satz leistet viel Arbeit, deshalb werde ich konkret.
Er bedeutet, dass der Agent übernimmt, wie wir arbeiten. Wie ein Repository aufgebaut sein sollte. Wie ein sicheres Deployment aussieht. Was ein Code-Review findet. Wo eine TYPO3-Installation unter Last bricht. Welche Server-Einstellungen ein Risiko sind. Was zu prüfen ist, bevor man einem Kunden sagt, etwas sei fertig. Das sind keine Modellfunktionen. Das sind zwanzig Jahre Webentwicklung und Serveradministration, geschrieben in die Skills, die Werkzeuge und die Regeln des Agenten.
Deshalb können wir einem Kunden eine versionierte, deployte und laufende Anwendung übergeben, statt eines Ordners voller Dateien und eines guten Gefühls.
Andere Anbieter verkaufen Ihnen Zugang zu einem Modell. Wir verkaufen Ihnen die Maschine, auf der es läuft, die Skills, mit denen es startet, und die Menschen, die beides gebaut haben.
Wenn Sie sehen wollen, wie das für Ihr Unternehmen aussieht, buchen Sie eine kostenlose Erstberatung. Bringen Sie den unordentlichen Teil mit. Darin sind wir gut.
Sind Sie bereit?
Sprechen wir über KI-Agenten.
Unterhalten Sie sich mit einem erfahrenen Experten, der weiß, wovon er spricht.